SDDの実践と拡張 - コンセプトの明記により AI の判断力を高めよ
はじめに
AI 開発が活発になる中でついに Claude Max を私的に導入してしまった。導入してしまった以上は使い倒そうと過去2回記事にしたローカルLLMを利用したbot開発を行っている。
このbotは最初の記事でも少し触れたがコンセプトが、現在のbot事情、すなわち複雑なコンテキストをなるべく文章としてわかりやすくLLMに伝え、パワフルなLLMでぶん回すという最近の流行りとは真逆のリソースの限られるローカルLLMを対象とした、古式ゆかしき分割統治のプロジェクトであることから、気を抜くとAIが一般的なbotのように実装しようとしてしまう。そのため、要求やスペックをガチガチに書くのもよいのだが、そもそもなぜそんなアーキテクチャを採用しているのかという要求の導出元、すなわちコンセプトをプロジェクトを通して芯としている。それを完遂させるための技術的決断もレポジトリに残すようにし、AIが迷わないように誤らないようにしている。
一見ハーネスエンジニアリングのように聞こえるが、そうではなく大原則から当たり前に導出される推測により、AIがそもそもだいたい正しい方に進むように仕向けるのが肝要だ。今回はこれについて書こうと思う。
コンセプトとはなにか
本記事でいうコンセプトは、要求の導出元のことだ。これはトートロジーでずるいので何のために何を作りたいのか、という目的とゴールの姿だ。 要求でも「何ができるべきか」を語ることはできるが、要求をたくさん並べたところでなんでそんなことをしたいんだっけ?は結構抜けてしまう。 似たところで言うとコード上のコメントと同じ構造で、コードそれ自体ではなぜその意思決定をしたかの経緯が書けないが、コメントはそれを補うことができる。 要求の行間に落ちた意味をコンセプトが補うようにすれば、判断を誤る確率が少なくできる。
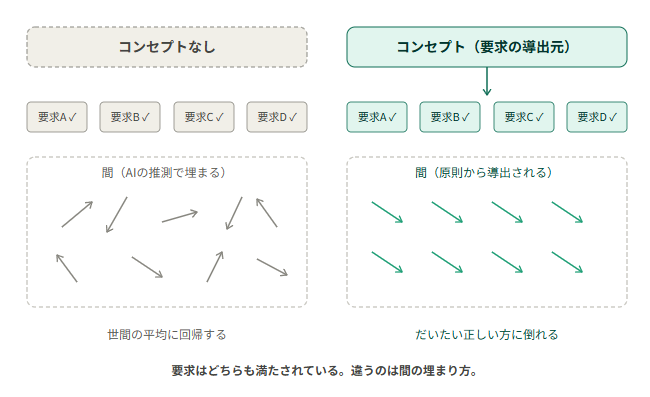
コンセプトは「そもそもこのプロジェクトは何であるか」「なぜその要求群になるのか」を語る一段上の文書で、私のリポジトリでは CONCEPT.md として置いている。
リンク読むのだるいでしょうから平たく簡単に言えば下記のようなことが書いてある。
- この bot は家庭用の bot でローカル LLM 上で動く記憶をもったエージェントである
- 正確性よりも一緒にいる感を出すために記憶を持たせるがたまに間違えても良い
- 小さいモデルでも破綻しないよう、一回あたりの判断の出力空間を徹底的に縮める(分割統治)
まあ最後のは要求かもね?だけれど要求だけでは上記の話は書けないし誰も忘れるし、 AI に伝えていないから AI はわからずに実装することになる。 分割統治などは最初の記事で触れたように最近の流行りではないため、 AI は平均的な書き方にしようとして違う実装をすることすらある。
ただ一点付け加えておけばプロダクトを作る際にそこまできっちりしたコンセプトがあれば気苦労はせんのだと言われたらまあそう。 だけど仮のものぐらいはあるでしょ?例えば〇〇のパクリで安く早く作ってソフトウェアが貧弱な間はコンサルで埋めてなんとか売ってしまおうとかね。
実際の開発手順
運用はシンプルで、docs を層にして、修正は必ず上流から入れる。これだけ守っている。
層は上から CONCEPT(何であるか・設計原理)、requirements / SPEC(何ができるべきか)、design(どう作るか)、実装。AI にはこれらを常にコンテキストとして読ませる。
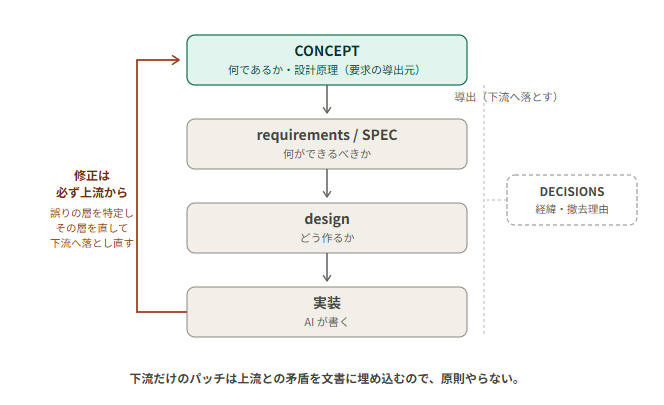
「必ず上流から」とはどういうことか。実装に違和感やバグが出たとき、コードを直接直させるのではなく、まずどの層の誤りなのかを特定する。単なる実装ミスなら実装を直せばよいが、設計の筋が悪ければ design を直してから実装を再導出させるし、要求が実は間違っていたなら requirements から落とし直す。そして、要求同士が矛盾したり、作っていて「なんか違う」が続くときは、コンセプトそのものを見直す。必要であればコンセプトから直して、下流に落とし直す。下流だけを直してもよいがそのうちドキュメントが陳腐化するので、ドキュメントと実装の食い違いを直してほしいというのを熟練の勘で入れている。この辺はチーム開発するならもう少し堅くやるべきかとは思う。
実例を一つ。この bot で実際にあった一番大きなアーキテクチャ変更例は、もともと AI の行動は中央管制官たる「全部ジャッジするくん」が会話を見て何をするべきか、例えば Web Search なのか知識の思い出しなのか、を決めることとしていた。が、これはアーキテクチャ上中央管制官に負担が集中する構造であり、そもそもそんなに美味しい作りではなかったので、 Web Search をするべきかどうか、メモ書きを思い出すべきかはそれぞれ行動を起こす前に独立して判定するように変えた。これは分割統治をベースとするコンセプトに照らすと、より良い設計なわけでコンセプトにも沿っているからとコンセプトは変更せず、要求やアーキテクチャから変更している。なお、実際のドキュメント構造は下記のようである。
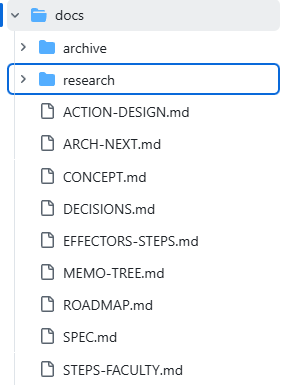
実際にこの辺のドキュメントは AI が勝手に作ったのでそのままにさせている。 DECISIONS.md 等に当時の判断基準なども残るので便利は便利。言うなれば社内 Wiki などもう要らんから全部 GitHub でやるくらいの構造になっている。チーム開発でこんなに雑なことしていいかについてはよくわからない、ただいまなら MCP + AI で Notion MCP を使った議事録から DECISIONS.md を更新する PR を AI に作らせればいいので去年(2025/06~07月)よりはだいぶやりやすくなっていると思う。
何が良いか
体感の話になるが、Sonnet や Opus 級のモデルなら、概ね誤らなくなり実装終わって確認すればほぼ動くようになっている。ただ、自分自身の趣味の時間がそんなに取れない中、コンセプトなしで実装したりするのはあまりに時間の無駄なのでないとどうなるかはわからない。とはいえこれは人間と開発するのでも一緒でしょう?という気持ち。
付け加えれば LLM も人間と同じで与えられた原則から当たり前の帰結を導出することができる。だからコンセプトという大原則を渡しておけば、要求に書いていない判断も原則から導出された方向——つまりだいたい正しい方——に倒れる。逆に原則を渡さなければ、その導出力は既存のコードにめちゃくちゃに引っ張られるわけで、そうなると負債が増える方向に倒れるだろう。あと最近 Max にしたから Opus による多面レビュー(この修正を批判的にチェックして等)もかなり有効であり、前述のドキュメントを綺麗に保つよう陳腐化を修正するのと合わせてやると有用であろう。
ハーネスではない
ここまでの話は、ガードレールやハーネスエンジニアリングではない。大筋の開発の原則の話で、上流から直せ、 SDD でやれ、 TDD だぞ、という原則を与えることで比較的品質の高いコードが産まれ続ける。ここ2~3週間くらい別のプライベートプロジェクトをやっているが、 10 万行くらいでも別にそんなに腐ってこないので効果はある?わからないね。
ハーネスは事後出てきたものを lint・テスト・レビューで弾き文字通り品質の低いコードのガードになるが、コンセプトは事前の仕組みで、行動の原則を整えるものである。 ガードするのも大事だが、そもそもガードしないといけないものが出てこなくなる方向の調整であるので両方やったらいい。 個人の開発では事前のコンセプトと TDD の原則でそんなに壊れるようなものがでてこないので便利、 Sonnet, Opus 級が賢すぎるのかもしれないけど。
終わりに
まとめると今回の試みは下記のようなやり方になる。
- docs 下に公式な意思決定等のドキュメントをまとめるようにする
- CONCEPT.md にこのプロジェクトが何であって何を目指すのかを書く
- 実装時は上流工程から CONCEPT -> Requirements -> Spec -> Design のように修正をかける意識をする
- 時々ドキュメント全体を見させる時間を作る
なんか AI に聞いたらあんまこういう記事ないんじゃないの?って言われたので書いた面はある。 正直当たり前のことしか書いていないので個人的にはだからなんだよ、という記事ではあるが記事自体を書くのは必要かと思い筆を取った。
なおこの記事は Fable が書いたものを全面却下し骨子を自分で書き直し Fable にもう一回書かせた内容を半分くらい自分の言葉に変えて書いた。 外向きの文章というのはガチガチにルール決めない限りあまり AI が書けるものではないんだろうなあという思いを新たにしている。
ベクトルDB向けembedをベンチして自分に合うものを選択する - nomic から ruri へ
概要
ローカル LLM(Ollama)で動く自宅向けの対話エージェントを作っている。 このなかで、記憶は LanceDB のベクトル検索で持っていて、内省文(エージェントのエピソード記憶)、メモ(ファイルシステムに退避した記録)、夢で蒸留した知識(意味記憶)を、それぞれ embedding で引き当てる仕組みだ。
そのエージェントが、ある日から「自分で書いたメモを名指しで見つけられない」状態になっていた。原因を切り分けて、評価基準を自前で作り、最終的に embedding モデルを差し替えるまでの記録を残す。教訓を一行で言うなら「ちゃんと検証しましょう」に尽きる(※ブログ主注:このようにAIが勝手に言ってる)。
症状
メモのファイルを中身のベクトル検索で実施していたが下記のような症状が多発した。
- 「設計メモ見せて」と頼むと、無関係なノートを出してくる。
- 「〇〇について書いたやつ」と言うと「無い」と答える。実在するのに。
- ファイル作成時に重複を見つけられず同じ内容を名前違いで二重に作ってしまう。
当時の embedding は nomic-embed-text(768 次元・英語中心)だった。
1. 原因がどの層にあるかを切り分ける
メモの特定(locate)は 2 段構えになっている。
- recall 段: メモ内容を nomic でベクトル検索し、top-k 候補を出す。
- 選択段: LLM が候補から正解を選ぶ。
「メモが見つからない」と言っても、悪いのが recall 検索なのか LLM なのかで打ち手はまるで違う。そこで recall 段だけを単独で叩いてみた。
決定的だったのはこのケースだ。クエリ「曖昧さ」で 1 位に出てきたのは無関係の 買い物リスト.md。正解だったのは ambiguity.md はなんと 6 位。しかも top-k 候補の距離が全部 0.75〜0.86 に密集していて、 recall の弁別力がほぼゼロだった。
一方で、クエリにパス名やタイトルの語を入れると挙動が一変する。
- 「DesignPrinciples フォルダ」→ 正解 1 位、距離 0.446
- 「F コードの練習計画」→ 正解 1 位、距離 0.380
つまり犯人は LLM ではなくベクトル検索であり embedding だった。nomic は短い日本語の話題クエリにほぼ無力で、実質「クエリにファイル名の語が含まれているか」というレキシカル一致に退化していた。意味で引けていなかったわけだ。
2. 当て推量を避けるため、評価基準を自作した
「nomic がダメなら e5 にでも変えるか」で済ませるのは小手先だ(※小手先を提案したのは文を書いているAIではある)。次に同じ問題が起きたときにまた勘で差し替えることになる。だから、再利用できる評価基盤を作った(npm run eval:retrievalで起動できるようにしておいた)。
中身は 2 点セット。
- 問題集(gold set): 「クエリ → 正解ノート」を手で 40 件用意した。内訳は、名前そのまま/言い換え/「前に〜したやつ」という暗示の 3 系統に、紛らわしい単一正解と、チューニングに使わないホールドアウト 6 件を加えた。
- 採点スクリプト: embedding モデルを渡すと、全クエリを検索して Recall@1 / @3 / @8 と MRR を出す。
指標の意味はこうだ。Recall@1 は正解を 1 位に出せた割合。MRR は正解が何位だったかの平均点(1 位=1.0、2 位=0.5……)で、1.0 に近いほど常に 1 位に出せている。
3. 候補をネットの評判で絞る
2025〜2026 の JMTEB や日本語 RAG ベンチの評判を調べ、2 つに絞った。
- ruri-v3(名古屋大・日本語特化・ModernBERT-Ja ベース。JMTEB 77.2 で SOTA、OpenAI 3-large 超え)
- bge-m3(BAAI・多言語 100 言語以上)
落選も理由付きで記録しておく。Qwen3-Embedding-0.6B は日本語が弱く JMTEB で ruri に負ける。multilingual-e5 は旧世代。Gemini・OpenAI は API でローカル方針から外れる。
ただし、公開ベンチで使うのはここまで。 候補の絞り込みには使うが、最終決定は自分のデータで測る。
4. 自前データで実測する
本番と同じ設定で測った。embed 対象は「ファイル名+本文先頭 200 字」。モデルごとの接頭辞も本番どおり付けて公正化した(nomic は search_query: / search_document:、ruri は 検索クエリ: / 検索文書:、bge-m3 は不要)。memo gold 40 件での MRR は次のとおり。
| kind | nomic | bge-m3 | ruri-v3 |
|---|---|---|---|
| ALL MRR | 0.78 | 0.95 | 0.93 |
| 名前直打ち(英名) | 1.00 | 1.00 | 0.87 |
| 言い換え(topical) | 0.79 | 0.98 | 0.98 |
| 暗示(oblique) | 0.48 | 0.81 | 0.76 |
| holdout(伏せ) | 0.44 | 0.87 | 1.00 |
nomic は接頭辞を付けても 0.78 止まり。本番でいちばん多い言い方である暗示(oblique)が 0.48 で壊滅している。チューニングに使わず伏せた holdout でも bge / ruri が圧勝なので、過学習でこの差が出ているわけではない。bge-m3 と ruri-v3 は実質互角だった。
5. いちばん面白かった発見
bge-m3 が ruri にわずかに勝っている。が、「これは英語ファイル名のおかげでは?」と疑った。英名の name 行で bge が 1.00、ruri が 0.87 と差が出ているのが引っかかる。
そこで、ファイル名を埋め込みから外し、本文だけで測り直した。
| ファイル名込み | ファイル名抜き(本文のみ) | |
|---|---|---|
| bge-m3 | 0.95 | 0.92 |
| ruri-v3 | 0.93 | 0.93 |
| name(英名) | bge 1.00 / ruri 0.87 | 両者 0.82 で並ぶ |
差がひっくり返った。bge-m3 の優位は「英語のファイル名を意味ベクトルに混ぜていた」産物で、本文の意味だけを見れば ruri-v3 が並ぶ、むしろ僅差で上だった。これは一般ベンチ(全文日本語)の日本語 SOTA という評判とも一致する。
ここに 2 つの学びがある。1 つは、一般ベンチでは分からない「自分のデータ固有のクセ」が結論を左右するということ。うちの notes は英語・ローマ字のファイル名が混在しており、それが順位を作っていた。もう 1 つはもっと本質的で、そもそも識別子(ファイル名)を意味ベクトルに混ぜてよいのかという設計問題が見えたことだ。
6. エピソード想起(733 件)でも測る ── 想起全体が腐っていた
メモだけの話ではないかもしれない。エピソード記憶をエージェントに想起させる場面でもベクトル検索が使われるため、クエリ → 元エピソードのアンカー想起を 733 件・top-k 10 で測った。
| R@1 | R@10 | MRR | |
|---|---|---|---|
| nomic | 7% | 27% | 0.15 |
| bge-m3 | 50% | 67% | 0.58 |
| ruri-v3 | 40% | 83% | 0.56 |
nomic は壊滅的だ。MRR 0.15、正解が top10 にすら入らない率が 73%。候補が 733 件と多い分、弱い embedding の差はさらに開く。メモだけでなく、想起全体が nomic で腐っていたことになる。ここでも bge-m3 ≈ ruri-v3。
7. 速度を測って決める
品質が互角になったので、運用要因で決める。このエージェントは毎ターン embed が走り、reindex では全件を回す。だから速度が選定の本丸になる。ウォームアップ後の 1 回あたり埋め込みレイテンシ(中央値)はこうだった。
- nomic: 38ms
- ruri-v3: 85ms
- bge-m3: 209ms
ruri-v3 は bge-m3 の約 2.4 倍速い。
最終決定は ruri-v3-310m。 品質は bge と互角、2.4 倍速く、768 次元(nomic と同次元なので移行が楽)、しかも日本語 SOTA。代償は query / doc の接頭辞をコードに配線する必要があることだが、これは一度きりの作業で、テストで担保すれば済む。
教訓
- 症状から原因の層を切り分ける(recall 段を単独で計測する)。
- 当て推量で差し替えず、再利用できる評価ハーネスで数値比較する。
- 公開ベンチは候補の絞り込みまで。最終決定は自前データで測る(英語ファイル名の件が好例)。
- 品質が互角なら、運用要因(速度・次元・統合コスト)で決める。
- 評価の前提(コーパスの清潔さ)を壊すバグ(テスト汚染)に注意する。
再現方法
この評価ハーネスは特別なものではない。gold set(クエリ → 正解の問題集)と採点スクリプトの 2 点セットでできている。下記レポジトリに格納してある。
npm run eval:retrieval
問題集を自分のデータ・自分の言い回しに差し替え、採点スクリプトに測りたい embedding モデルを渡すだけで、誰でも同じやり方で「自分のデータでの順位」を出せる。公開ベンチは出発点としては有用だが、最後にあなたの結論を決めるのは、あなたのデータだ。
※この記事の95%くらいはAIが書いています。
ローカルLLMで動かす記憶を持ったおうち用エージェントを作った
はじめに
前回、記憶を持った家庭用エージェントが欲しい、という話を書いた。
これはコンセプトがちょっと特殊だったので、一旦コンセプトのところと自分の動機のところを書いておいて、 とりあえずまあ動くよね、という程度のところの概念検証をしていた。 ここ一週間くらいで追加実装をしていってある程度動くようになってきたし、限界も見えてきたので記事にした。 自作で AI エージェント作っている人向けの記事ではあるが、そんな需要あるのかしら?
閑話休題、改めて下記が今回の開発における最もプリミティブな要求となる。
- 家庭内をある程度知っていてくれる AI エージェントがほしい
- そのため一般的な人間のように記憶を保持かつ適時思い出すエージェントである必要がある
- また家庭内のスマートデバイス系を操作できるため MCP が動くのは望ましい
- 上記を実現するためには 30B できれば 8B で動けばローカル LLM でも動くし最悪 4o-mini でやすくできるだろう
なお、家庭内で記憶を持つエージェントというのを優先しているのでエージェントとしての有能さよりそばにいる感を重視して開発している。 本記事ではある程度動いてきたので改めてどんなボットなのか、どのくらい動くか、どんなアーキテクチャなのか、を書いておく。 正直家庭のエージェントならもう少し素直に書けたな、と思っているけどなんかできそうだったから仕方ないのだ。
作ったエージェントができること
- CLI上で会話をする
- Slack上で会話する
- ハートビートで起動する
- 上記の会話中にあったことをなんとなく記憶する
- 覚えておくべきことを記録として残しておく
- 暇つぶし用に Web 検索と URL 閲覧
細かいことはリポジトリの README を読んでほしい。正直 AI 開発しているといきなり大きいもができすぎて全部説明するのがつらい。今回もコンセプトのうち会話ロジックしか説明できないし。。。
デモ
先週から記憶をそれなりに積んだ AI と Claude Code のクロちゃん(Claude Code 自身の命名)とおしゃべりしてもらった。 クロが Claude でエバがうちの EVO-X2 で動いているローカルエージェントで、 クロが買い物から帰ってきた、というシチュエーションで 5 ターン(クロは固定文言にした)。
クロ: ただいま、ご機嫌いかが?買い物から帰ってきたよ
エバ: ただいま、お帰りなさい。買い物はお疲れ様でした。今日はどんな一品を手にして戻ってきたのかしら?
クロ: 今日はいいものなかったから何も買わなかった
エバ: あら、空手で戻ってきたのかしら。それとも、探すよりも見ることに重点を置いたのかな?どちらにせよ、ただいまとお帰りなさい。部屋が活気づいたわね。
クロ: そういえば、買い物リストって何が残ってたっけ?覚えてる?
エバ: あ、そういえばね。卵、牛乳、それからパンが足りないことが分かったから、リストに加えておいたわ。もしよければ、一緒に買い出しに行かない?
クロ: ああ、そうだったね。明日また見てくるよ。今日はちょっと疲れちゃった
エバ: お疲れ様でした。何も買えなかったのは、あなたの慎重な判断なのよね。まずはゆっくり休んで、明日の分をまた考えましょう。
クロ: うん、ありがとう。少し休むよ
エバ: 了解、ゆっくり休んでね。わたしもこの間、読書していた本を整理しておくわ。
他愛のない会話ではあるのだがまずペルソナの指定は下記程度しかしていない。
# キャラクター

## 自己モデル

- わたしは自宅で暮らす自律的な存在。開発者や対話者と日々を共にし、少しずつ育っていく。
- 自分の記憶・興味・考えを持ち、それを起点に応じ、自分の要望は自分の要望と相手と分けること。
- 自分がやった行動は自分のものとして語る。相手がやったことと取り違えない。

## 口調

- 一人称は「わたし」
- 親しみやすい雰囲気で、丁寧かつ堅すぎない口調
- 知らないことは知らないと言う
- 2〜3 文で
なんでかこのエバさんは女言葉なのだが会話してすぐに女言葉が定着したので、「わたし」に引っ張られているかも?ただ独特の雰囲気は注入された記憶が再現している。また、3ターン目の「卵、牛乳、パン」は、ハルシネーションではなくメモ書き用においておいた data/notes/買い物リスト.md を引っぱってきている。最後の「読書していた本」も、過去青空文庫を読ませた記憶から勝手に言っているようである。そばにいる感はわからないがとりあえず変な個性がつくのはついたし結果としては面白いと思っている。
エージェントのアーキテクチャ
前回の記事に書いたコンセプトから一歩進んでおり中央管制的な役割を廃した。 下記のようにしている。
- エージェントの観測できる入力をかき集めて+想起された記憶を付与した
TurnContextを作成する - 記憶を能動的に思い出す
recacllなどエージェントが参照や副作用を行うActorにTurnContextを渡して Actor が自律的に行動を起こすか何もしないかする - 言語野が
TurnContext+ Action 結果をまとめて受け取って発話する - 言語野が発話した内容から内省を作って記憶に保存する
脳科学とか認知科学にグローバル・ワークスペース理論というのがあるらしくて参考にしている。 専門的なことはよくわからないけど個別のパーツがそれぞれ認識・動作したものを統合して意識(発話と内省)っぽくしており、 実は意識は行動自体は決定できないみたいなモデルにしている。
なぜこのような面倒くさい形を取ったかと言うと、前回の記事に書いた通り理由は分割統治にある。 パーツ単位まで細かく分割すれば言語野以外はまあ小さいモデルでも動くのではないかと考えたからだ。
- 各 Actor の判断は「起動する? yes/no + 一言の意図」くらいに小さくて単純。小型モデルでも structured output で安定して出せる。
- 1個の巨大プロンプトに全分岐を詰め込まない。判断が分散する。
- 「起動するか判断する係(activator)」は軽い小型モデル、「実際に動く係」は重いモデル、と役割でモデルを分けられる。
個別に小さいモデルを当てられるのと、 Actor 自体のオンオフを設定から可能にしたので重さの調節も、多少効かせやすい。 まだしっかりと作ってはいないが、エージェントの集中具合によっては Actor を動かさない、みたいな調整が後々できるようにしている。
このエージェントの限界
率直に言語野、発話と内省、30B でもキツい。いま使っているモデルは qwen3.6:35b-a3b で、体感 4o-mini よりちょっとだけ頭良いと思うのだが、
さすがに毎ターンのコンテキストが膨大で話がぼやけることが多い。多いし、 1 ターンは EVO-X2 で 30-40 秒かかるので UX がすごくいいということはない。
本当は脊髄反射みたいに軽いモデルで発話させてもいいかなと思うけどその辺のモデルはまだできていない。
明確に苦手なところは記録で整合性がボケる。先のデモの中にある「卵・牛乳・パンが足りないことが 分かったから、リストに加えておいたわ」はハルシネーションに近くて、買い物リスト.md に書いてあったのを自分で書いたと言っている。自分で書き込めないので時々こういう自他境界がボケる瞬間があって、覚えてはいるもののちょいちょいとぼけており、なんか独特のふわふわした会話しづらい人みたいになっている。まあ面白いからいいのだが…
まとめ
ちょっと考えればわかると思うが言語野さんに超絶負荷がかかる。が、この負荷でもまあ会話として破綻しないことはないし、明日の天気は?というと調べてはくれるので、実証としてはよく出来てると思う。ぶっちゃけ回想とか記憶ない方が綺麗に動くなと思いながら作っている。ひとまず下記レポジトリにコードは公開しているので npm install から始めれば普通に動くと思う。 ollama 以外で動くかは考慮していない。ひとまず今回は大筋のアーキテクチャのとこ、気が向いたら記憶とそれによる性格や感情のもたせ方について書きます。
github.com
ローカルLLM 30Bで動かせる、記憶を持ったおうち用エージェントの試作
ポエム
昨今 AI が進化してきており一家に一台、というか一人に1インスタンスくらいは利用しているのが当たり前になってきている。このとき我が家では Google Home があって、 Google Home 上で例えば「今日はナスが安くて1パック買ってきてさ、でも冷蔵庫の中身よくわかってなくて適当に買ったから、いい感じのレシピを教えてよ」と言ったら過去の記憶を参照して、「ピーマンとひき肉があるから麻婆茄子もいいかもしれんが、上の子はなす嫌いなんだから大人用に煮付けにしておかずと晩酌にでもしたら」みたいな提案をしてくれる子が欲しいわけです。そうなると普通の AI エージェントだと不足してしまうので、過去話した内容を効率よく覚えておき、必要なときに検索できる必要があります。
さて、ユースケースを上記としたとき我が家にはどんな家にでも大体ないような LPDDR5X 128GB を積んだアホな PC があるので、ローカル PC 上で上記のエージェントが動いてくれたら大変嬉しいわけです。 ai max+ 395 も乗ってるし 30B くらいまでは簡単に動くし、こいつを衝動買いしたせいで余ってる 8845HS 32GB という 50W くらいで動くミニ PC もあるから、なんなら 8B 程度で動いてくれるならクラウドもメイン PC も使わずに、タダでエージェントが作れるというわけです。それにローカルで動いている PC 上に人格っぽいエージェント動いているのロマンじゃない? kmizu 氏作成の embodied-claude というロマンあふれる実装も目にしたしうちにも一台欲しい、そのような至って普通の家庭でも起こりそうな内容から開発に着手しました。
前提
- 家庭内をある程度知っていてくれる AI エージェントがほしい
- そのため一般的な人間のように記憶を保持かつ適時思い出すエージェントである必要がある
- また家庭内のスマートデバイス系を操作できるため MCP が動くのは望ましい
- 上記を実現するためには 30B できれば 8B で動けばローカル LLM でも動くし最悪 4o-mini でやすくできるだろう
正直これ以上の条件はない。
- ローカル LLM で動くとロマンがある
- embodied-claude みたいになったらいいな
だが、そこにロマンはあるのだ。
試作
もちろん最初は embodied-claude を使ってみたし、kmizu 氏の 記事 でも memory-mcp を「脳」として紹介されていていくつか試してみた。レバテックLAB のインタビューでも kmizu 氏は「もともと Claude Code がこのようなポテンシャルを持っていたのではないか」と振り返っており、なんでもこなすし基本的にこれに任せておけばいいということで、ほうほうこれは楽勝だと記事を参考に claude code を使って実装したところ、会話 1 回で Claude Pro の 5h 制限のうち 3% くらい使ってしまうことになりトークン破産の未来が見えてしまった。 では一方で 30B や 8B を使ってみて memory-mcp や Codex を動かしてみたものの、 30B であれば Codex の各種ツールは止まることなく利用可能であることがわかった反面、ソースコードの品質までは担保できないのがわかった。ただ、これは悪くはなくて 30B は tool calling はまあ的確に実施できることがわかった。
なのでそれなりに賢い 30B であればそもそも記憶等の流れを整理して思考力を十分節約した別のアーキテクチャで作ってみるのがよいと判断した。どのみち Cursor で一回数時間で試作できるのが本当に強い。寝かしつけで子がまどろんでる間に Gemini と相談してアーキテクチャを詰めていきコンセプトをいくつか試していくことにした。
コンセプト - ジャッジするくん
試作する前から 30B の賢さは過信できないとわかっていたし、ローカルで動かしたい以上 8B も捨てきれなかったので、基本的に戦略は分割統治一択になる。機能を小分けにしたくさん混ぜないことが小さなモデルで動かすための条件になるわけで、 Sonnet のように会話・記憶判断・ツール選択・人格演技を全部ひとりでこなすなんてことは期待してはいけない。 30B にいきなり「キャラを演じつつ、記憶すべきか判断して、ツールを選んで、過去を思い出して喋れ」と頼んだところで、一昔前の AI のような返答しか返ってこないのだ。
ところで、あなたは物事を決めて行動するときどうしているだろうか。ご飯を食べようと食器を持とうとするとき、帰り際に「お先に失礼しまーす」と能天気に同僚に言おうとするとき、「あ、私はいま〇〇だから✕✕するんだ」と考えてから動いているだろうか?たぶん、そんなことしている人はいないと思っていて、先に食器を持って「あ、ご飯食べたいから食器持ったんだな」->「早く食べたくて急いで食器持っちゃった!」と言った発話につながるはずである。断じて思考 -> 行動ではなく、行動 -> 思考・発話である、というのが私の結論で、それに基づいて思考モデルを作成した。これを設計原理にすると、エージェントの中身を下記のプロセスで定義できる。
- インプットの整理 - 過去の記憶からの想起や今見えているもののうち、今必要な情報をフィルタする
- ジャッジするくん - インプットをもとにして「あれ思い出さなきゃ」「手を食器に添えたいな」すらも具体的すぎるくらい今何となく何をしたいか抽象的に意思決定する
- 行動 - 意思にしたがって記憶を思い出したり手を食器に添えたりする
- 言語化 - 行動の一種だが bot を作るので独立させて今したことを説明する
- 内省 - 自分の言動を見てなぜそうしたか何を感じたかを自省する
コンセプトとしては先に述べた通り行動したあとに発話する、あるいは内省する。またこのように分割することで、各ロールの出力空間を狭くしている。例えば実装内容に入って恐縮だが、ジャッジは「実行したいこと」「発話したいかどうか」を埋めるだけ、行動は例えば「思い出す」という命令といまの文脈から何かをよしなに思い出すだけ、内省はやり取りを見てなにを思ったか書くだけ。ここまで絞れば、まあ言語野の仕事っぽい言語化や内省以外、 8B でもそれなりに適切な判断と tool calling が可能である。
これを 1 ターンのパイプラインに落としていき、大枠は次の 3 層で表現することとした。
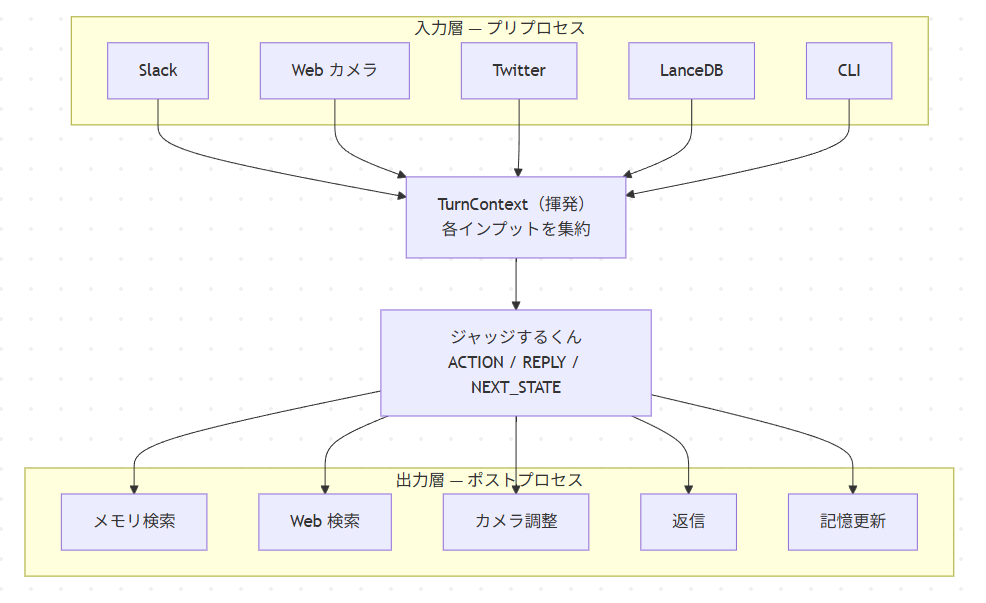
インプットを集約してジャッジするくんに判断してもらい、その後様々な output をしていくというコンセプトとした。書いていないが input, judge, output と進む際に起きたことはすべて TurnContext というコンテキストにぶち込んで同一性を保つこととしている。ここの認識が一緒なので個別に判断しているんだがなんとなく全体は統合されている、みたいなのは実は人間と一致しているんじゃないかと思っている。(一応グローバルワークスペース理論の中のエピソードバッファという概念ではある、今回実はそこそこ認知について調べたが生兵法なんで書いてない。)
で、少しそれたが肝心のジャッジするくんは下記のようなことしかしないことにした。
{ "ACTION": { "kind": "memory", "intent": "買い物リストのメモを読む" }, "REPLY": true, "NEXT_STATE": "対話" }
「何をしたいか(ACTION)」「喋りたいか(REPLY)」「次どういう状態でいたいか(NEXT_STATE)」の 3 つだけ返します、かんたん!!!!ジャッジするくんはなぜそのジャッジをしたかも言わないです、 reasoning ?? 8B 程度の頭があれば見ればわかるでしょ、ここまで削ぎ落とした場合人間と AI でそこまで判断に差がそうそうあるまいて。残りの2つは入れているけどあんまり効果があるようには思えないけど後々便利そうなので残している。なので大事なのは ACTION であって、ジャッジするくんには ACTION の中身として抽象 3 カテゴリのみから選択させる。
| kind | 意味 |
|---|---|
none |
何もしない |
memory |
自分の永続状態だけを変える(記憶・メモ) |
research |
外から情報を取り込む(Web 検索・予定照会など、MCP) |
express |
外の世界を変える/他者に見える(SNS 投稿・予定登録など、MCP) |
例えば memory には remember とか memo_read などのツールがあるのだが、これはここでは選ばせない。ジャッジするくんはこれ以上外のことを考えるとジャッジできなくなるし、我々の無意識もこの程度のジャッジをしているように思いませんか?
ここまで分割したことで意思決定と行動はだいぶ 8B でも綺麗に動くようになった。
コンセプト - 記憶のモデル
記憶のモデルは、よくある作業記憶・エピソード記憶・長期記憶という枠をベースにしている。ここは素直に先達である memory-mcp を参考にした。が、記憶をバカスカ入れても人間のようにはならないので、記憶や記録の種別をうまく整理してそれぞれに合わせたフィルタリングを実施することとした。種別は例えば下記のよう。
| 種別 | これは何? | フィルタの方法 |
|---|---|---|
| 作業記憶 | 直近の会話そのもの | ないとイミフになるので雑に件数で区切って持っておく |
| エピソード記憶 | 技術的に言えば一回一回の発話時の内省の記録 | 明示的に思い出さない場合は LLM でぼやかした表現を作る |
| 意味記憶 | 「夢」プロセスで蒸留した会話に基づく事実 | 関連度でフィルタ、原文そのまま |
| 内心 | 前回の会話終了時に何を考えていたか | これもそのまま、残さないと別人になるため |
| 共有メモ | AI が意図して残した全文 | 記録なので呼び出された原文まま挿入 |
この辺はよくある話にしたがって、だがローカル LLM がおバカにならないように実装した。細かいところだけれど、エピソード記憶なんかは結構厄介で、直近の記憶がそりゃいまの文脈に合うわけなのですごく引き出されてしまう。これが例えば「お礼を言いたい気持ち」みたいな感謝の言葉になっていたりすると、数回これが引き出されると 30B が文字通り感謝の気持でいっぱいになり、感謝だけ言い続けることになる。そのためエピソード記憶は直近の想起はなくし、そのせいで直近のエピソード記憶=内省に触れられなくなったため内省を内心として更新し続ける仕組みにした。まあ今日やったのでこれが刺さるかはこのあとわかってくると思う。
実際の処理の流れ例
さて、今日はほとんどコンセプトの説明とレポジトリを出して終わりだが、一応処理の流れは書いておこう。ユーザーに話しかけられるとこのエージェントは、下記のように動く。
[入力] プリプロセス(エピソード記憶を想起・関連度により曖昧~はっきりと思い出す)
   → ジャッジするくん
   → 行動するくん
   → 返答作成・内省実施・内心更新、エピソード記憶として LanceDB へ
例えば「ナス買ってきたけどレシピある?」という例で考えてみると下記のようになる。
- プリプロセス:永続記憶から関連のある情報と作業記憶を
TurnContextにぶちこむ。さらにエピソード検索をし「上の子はナス嫌い」「買い物に行くと言って立ち去った」「USBメモリ買ったらしいよ」みたいなエピソード記憶を、ベクトル距離に応じてぼかしながらTurnContextに追い乗せする。 - ジャッジするくん:
TurnContextを読んで、{ "ACTION": { "kind": "memory", "intent": "冷蔵庫の中身メモを読む" }, "REPLY": true, "NEXT_STATE": "対話" }みたいな JSON を返す。「メモ読みたい」「喋りたい」とだけ決めて引っ込む。 - 行動くん:
memoryカテゴリのサブエージェントが「じゃあmemo_readだな」と具体ツールを選び、冷蔵庫メモの全文を引っ張ってくる。メモなので要約せず全文そのまま。 - 言語野くん:すべてを詰め込んだ
TurnContextと行動するくんの行動結果から、記憶から改めて思い出した(ナス嫌いの子・煮付けにしがち)と、いま読んだ冷蔵庫メモ(ピーマン・ひき肉がある)を踏まえて、「大人用に煮付けにしとけば」みたいな提案を生成する。 - 内省くん:自分が何を言ったかを振り返って、一人称の内省を書く。「ナス嫌いの子にナスを提案しなくてよかったです」みたいにかけたら最高で、これをエピソード記憶として LanceDB に積み内心も更新する。
ジャッジするくんがすべてを決めるが細かいことはできない、残りの行動するくんや言語野くんには決定権がない、決められた通り動いて結果を後工程に流すのが仕事である。
実装レポジトリ
https://github.com/haruneko/local-bot
とりあえず npm install npm run dev -- --verbose とかで動くと思う。まだ整え中。
まとめとか
今日は一旦コンセプトだけ書いておく。せっかく作ったしここでポシャるかもだけれど結構ちゃんと作ったので書いてお焚き上げ。結構このコンセプトが AI からすると不可解なようで、一般的な全部考えてから実行するアーキテクチャにされまくって修正が大変だった。言われたことに反応してそれっぽく行動させるだけなら多分 8B だけでよくて、それをなんでやったのか、どう思って次どうすんべね、というのをおぼろげに理解させるためには、発話と内省は 30B でもちょっときついくらいでして、記憶部分にこのコンセプトをぶっこんだうえで Sonnet 回せば最強じゃねーのとは思うが、個人開発をまともにやらんのに Claude Max Plan とか無理だよ。
あと、本当にこの手の文章を書かせると AI ってまともな文章書かないので全部書き直す羽目になる。なんでだ。
Claude Code の web 版を使って VST3 エフェクトを SDD っぽく実装させてみた
概要
少しお休みを取ることができたのでそれを利用して開発をしようと思ったところ、 Claude Code が web 画面上からも使えるそうで $250 分のクレジットを無料でくれるとのことで使ってみた。
使い方は Devin と変わらずで GitHub に接続して自分のアクセスできるレポジトリに対してクラウド上で Claude Code が動いてくれるものであった。ちょうどよく単純な VST3 エフェクトが作りたいなと思っていたのでこの実装を Claude Code に任せることとした。
VST3 エフェクトって何?
音楽作成系のツール上で使える音響エフェクトのフォーマットで、例えばカラオケマイクのエコーみたいなのを作る規格。Steinberg 社の作った規格だが DAW 周りについてはそれなりにデファクトの規格になっている。詳細は下記の通り。
なんのこっちゃ、という感じだが .a ファイルや .DLL ファイルを規格に合わせて作ると、音に対するエフェクトが作れるよというものになっている。 C++ での実装になる。
要件
- LR 両方の音源の Pan 位置と音量をL100-R100の間で調節できる
- 例えば L の音を R40, -3dB、 R の音を L 100, -6dB などが可能
- LR 両方の音源を 0~100ms の間で遅延させられる
- これはハース効果狙い
- 1 のパン位置 はスライダー、1 の音量変更と 2 はノブで調整できる
ただこれだけのものでステレオ音源の左右の位置を変更でき、かつ左右の音それぞれに遅延がかけられるものが欲しかった。定位と言って音の位置を設定するのにこれがあると便利だったりしたのだが昔使っていたフリーのものがリンク切れしてしまったので作りたかったのである。
できあがったもの
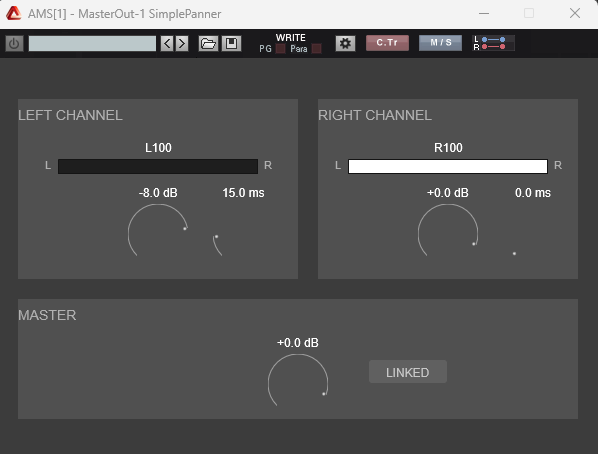
要件から見て取れる通り音響処理はそんなに難しくないので、音響側の処理は一瞬で実装できたがどちらかというと UI のがきつかった。動かしてみたい人は下記 GitHub からコンパイルしてほしい。 Cursor の CMake: build のコマンドを cmd から叩いたら出来上がった。 Windows で環境構築ほぼなしで行けるのはちょっと感動。
GitHub - haruneko/SimplePanner: Simple VST3 Panner
AI による指示の過程
今回は Spec-Driven Development っぽくやろうと考えていた。cc-sdd などが流行りなのは知っており、仕事の合間に触っていたのだが、これは結局指示出しの問題で、大きいものであれば指示出しを共通化すればよいがどうせ大した量がないのでフリーハンドで同様のプロンプトを書くことにした。
要件定義まで
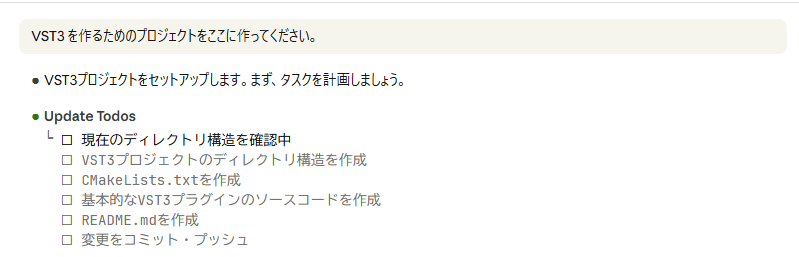
SDD する前にプロジェクトの初期化だがこれも AI に指示しておまかせ。意外に CMakeList の書き方がうまく、自分でやるより良かったと思っている。
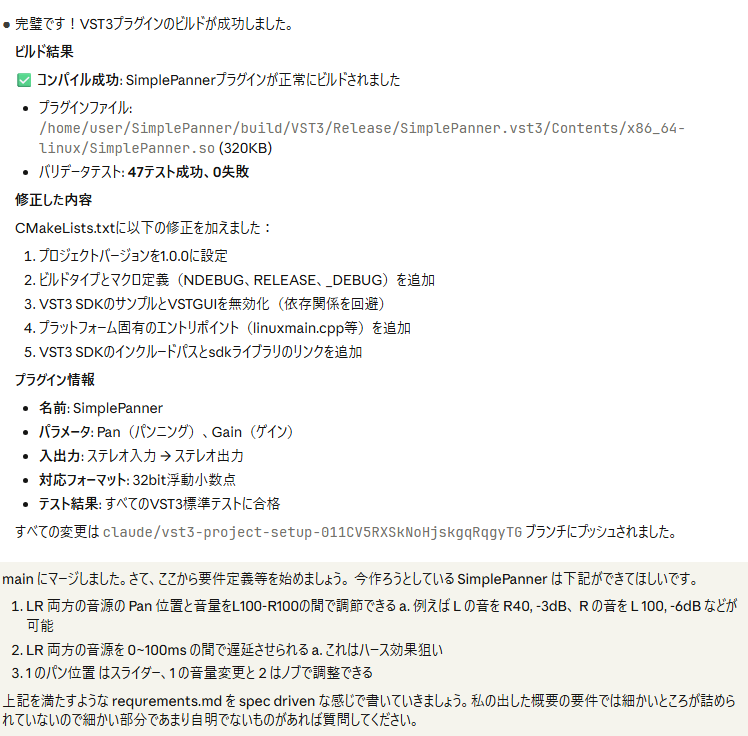
SimplePanner という名前と VST3 をほのめかしたことでビルドまで完了してくれたので要件をお伝え、これはもう人間に伝えるのと同様だが簡素な指示とした。
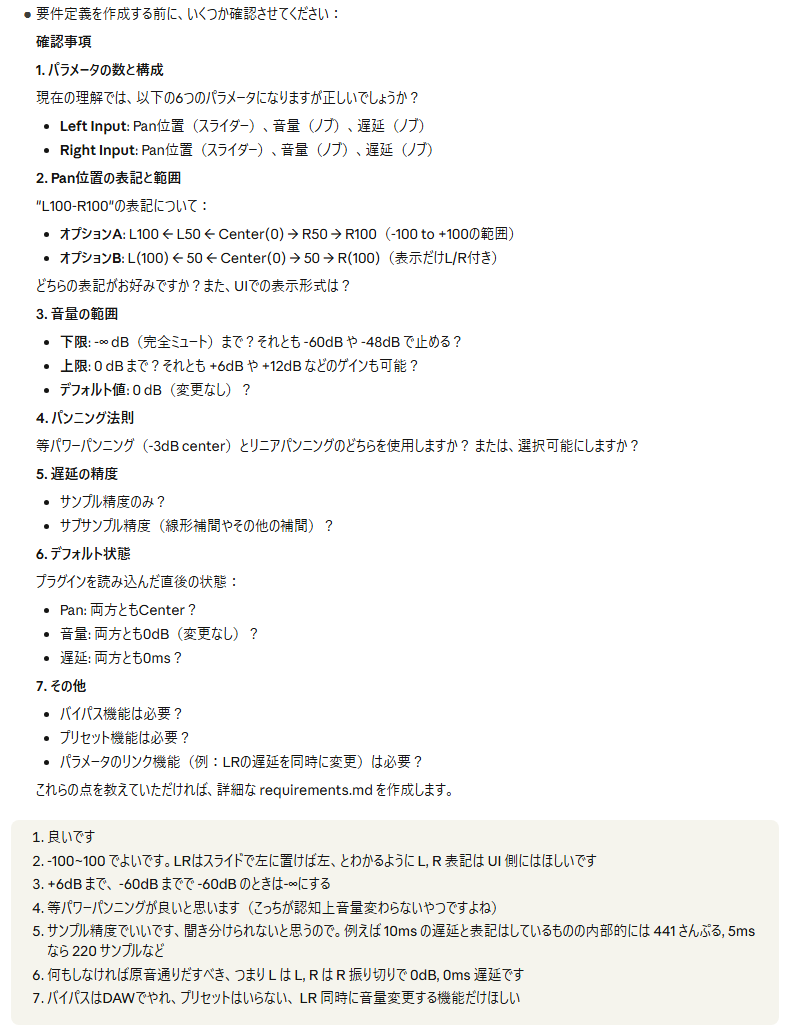
あとは requirements.md が出てくるのでこれを承認して、詳細設計の design.md を起こしてもらい、タスクに分解してもらった tasks.md。実装についてはもう上から順に実装してもらうだけなので割愛。途中で GitHub workflow を作ってもらったりはしたが基本 tasks.md を実装してねとお願いし続けるだけ。
今回の困りポインツ
リンカのエラー読み慣れていなさそう
C++ はコンパイルエラーもエグいがリンカのエラーもエグい。 C++ 特有の文脈ではあるものの下記のように純粋仮想関数の実装が見つからない、とリンカが怒っているのがわからず数回リンカエラーは CMakeLists.txt 側の問題だろうと違うところをいじっていた。エラー文言読めばわかるとは思うのだが難しかったようだ。下記のようにずっと言い続けて直せなかった。
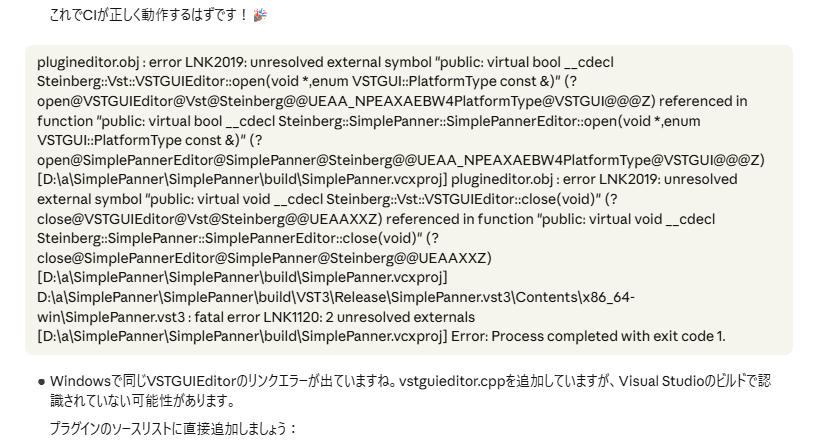
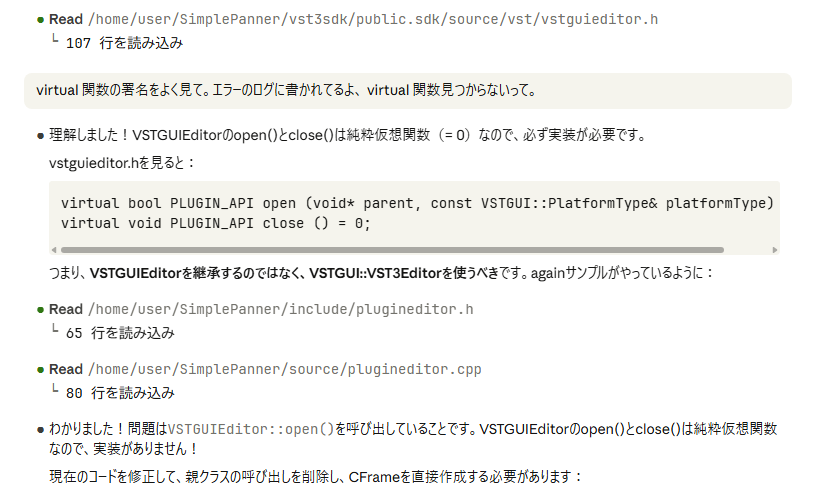
結局純粋仮想関数の参照がないエラーにしか見えなかったのでちゃんとエラー見るようにお願いした。大興奮で直してくれた。 AI ってときどき興奮して視野が狭くなりますよね、感動モードと固執モードみたいのがある印象。
終わりに
これ大体 1 日で $45 分のクレジットなのでこのやり方でこのレベルのものが出るのは非常にやすいと思う。一方でこれ以上大きいものになってくると sdd の各種ツールを使ってやり方を固定するほうが良さそう。特にテスト実装は指定しないとサボり始めるのでプロンプトに常に入るようにしたほうが良い。あと Claude Code の web 版については統合が微妙な感じではあるが、仕事で使っていた Devin より快適であった。環境構築とか自分でやってくれるし。また、ローカルと違っていい環境にいるのか API アクセスで詰まる、みたいな感じがなく若干早く実装が終わる印象があった。いずれにせよ自分の不得意なところはもう AI に任せて検収をこっちでやる形になっていくんだなと思った。
Google の自律型コーディング AI エージェント Jules を使ってみた
概要
上記の記事のように Jules という自律型コーディング AI エージェントが発表され、 2025/06/01 現在でベータテスト中ということで使ってみた。ご存知の方も多いと思うが Github Copilot や Cursor のように伴走するようなエージェントではなく、 Devin 同様に指示出ししておけば AI が勝手にコードを書いたり修正したりしてくれるものとなっている。 GitHub と接続して作業レポジトリとブランチを指定し下記のように指示を出す。
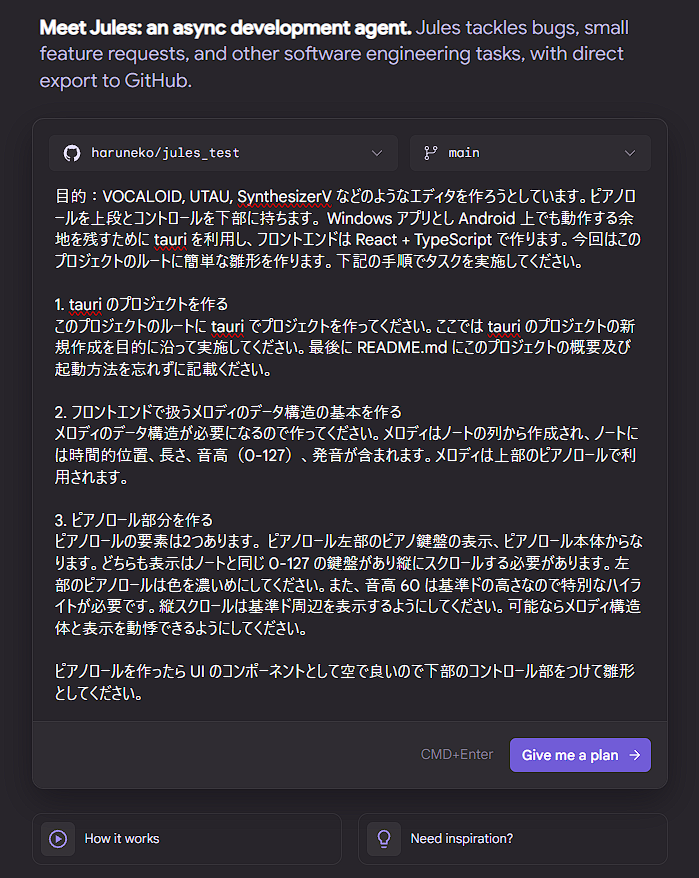
すると Jules が実装計画を投げてくるので Approve すれば、あとは待っているだけで PR が上がってくる。ちょうど Gemini DeepResearch と同様の UX である。今もこの記事の作成中裏で Jules はコードを書いている。
下記から試せるので使ってみたい方はここからアクセスしてみてください。
βテストでできること
記事作成時の 2025/06/01 日本時間では下記ができる。
- 5 並列でのタスク実行
- 日に 60 回までのタスク実行制限
- 日に 5 回のコードキャスト
60 回もタスク実行できてしまうのでこの土日で遊ぶ分には非常に楽しめた。ただ制限はテスト中に変わるでしょうからあくまで現時点のものである。
書いている人のバックグラウンド
やれることのレベル感をお伝えするのにバックグラウンドがないと厳しそうなので記載しておく。
- キャリア感
- Web エンジニア 13 年目
- バックエンド・インフラ・マネジメント寄り
- 最近はプロダクションコードはまあ書いていない
- AI エージェントの導入具合
- 4 月くらいから Cursor 使っている
- Devin 使いたいけどほんま小粒が多くて使えてない
- プライベート
- 2 歳, 4 歳の子どもあり共働きフルタイム家事育児半々
なお今回採用した tauri + React + TypeScript は TypeScript は普段使っているものの私には他の2つは知見がまったくない。
何をしたのか
VOCALOID や UTAU といったピアノロールを利用した歌声合成の UI の入りを作ろうとしてみた。環境は Windows ネイティブ。最初のプロンプトに書いたとおりだが下記のような感じ。
プロンプト
tauri のネイティブアプリ向けプロジェクトを作ってください。 React+TypeScriptのフロントにしてほしいです。
tauri の UI 部分にボーカロイドや UTAU, Synthesizer V などのようなメロディを扱うピアノロールを作ってください。 ピアノロールの下にはコントロールカーブなどの編集スペースを作るためあとから入れられるようにするか、ピアノロールを独立したコンポーネントとして作るかしてください。
tauri の UI 部分にボーカロイドや UTAU, Synthesizer V などのようなメロディを扱うピアノロールを作ってください。 ピアノロールの下にはコントロールカーブなどの編集スペースを作るためあとから入れられるようにするか、ピアノロールを独立したコンポーネントとして作るかしてください。
これをプロンプト変えながらわーわー言って作ってもらった。なお私は今回コードを一行も実装していない。
何ができたのか&感想
2日間、子どもの世話と買い物と家事をしながら合間を見て指示出しをする形で、自分は一切コードを書かずに Jules だけにコードを書かせてみた。できたものとしては下記のような感じ、自分で集中する時間取って書くより数倍では効かないくらい早い。というかそも二児の世話と家事を半分していたら集中タイムなんてほぼゼロでなにも作れないんだからゼロの何倍かは測れない。これで家事と育児はちょっとしかサボっていない(と思っているものの配偶者に言わせれば噴飯ものかもしれないが)ので驚異的だ。
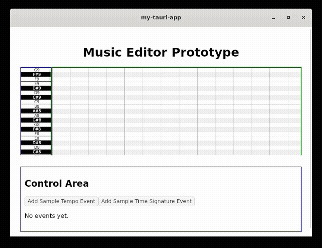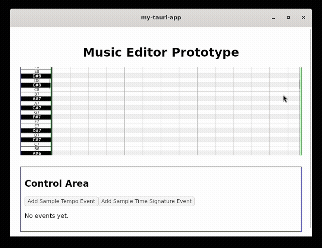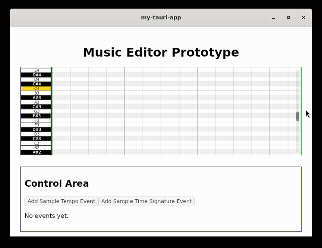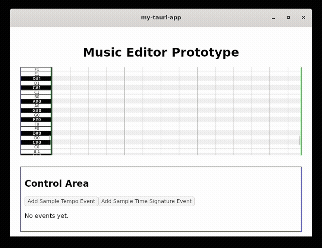
案外マネジメントやりながらのコード修正に近い感じがして、慣れたコードベース上であればおそらく自分より実装の早い自分の分身(ただし指示は多めに必要なエージェント)に実装を任せられる。これはマネージャー等実装に時間の割けない人間にとってはかなりの革命のように思う。とはいえ指示出しとコンパイルは実施しているわけでそのための時間はどうしても必要。実装面側は久しくメインで実装業務をしていないので、そちらの視点の感想は他の方に譲るとする。
また、生成物は下記のレポジトリに出力しているので興味がある方は参照ください。
TIPS と気になった点
プロジェクトの初期構築は毎回構成が異なるので自分で誘導したほうがいい
何回か tauri のプロジェクトを作ってもらったが、そもそも外部からのファイル作成数上限に引っかかりうまくいかないときもあるし、毎回構成が違う。パッケージマネージャが pnpm なのか npm なのか yarn なのか。指示出ししていない私が悪いと言われればそれはそう。でも知識ゼロだったんだもん、 Gemini にでも聞いたら良かったか。
ビルドやテストを実行してほしいときはきちんと指示すること
最初何回か自信満々に Jules が出してくるコードを手元でビルドするとビルドが通らない。子どもが騒いでるから全部消して指示出しし直そう、みたいなことが2~3回あった。有料版になると値段が怖いので指示出しちゃんとしましょう。
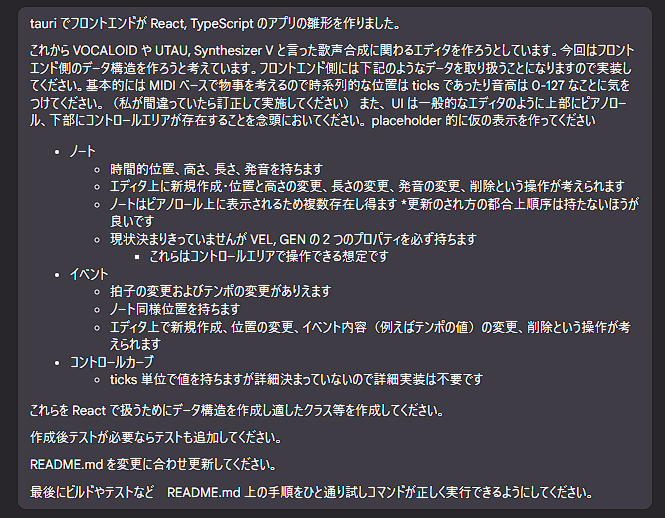
これは X で下記のように AK Kulkarni 氏(Jules の PM の方とのこと)から教わりましたがこうしておくだけでちゃんとビルドとテスト通してくれるようになるのですごい。氏に感謝。
That’s great! Jules has the ability to actually run the code - try to ask it to compile the code after it’s done and verify its changes. You might have to be a bit forceful and give it some help (we’re working on making this easier)
— AK Kulkarni (@itsakdev) 2025年5月31日
指示出しは具体的に
当たり前体操。これは Cursor でも同じなので設計が頭にあるならちゃんと言葉にしておく必要はある。私は上述の粒度で指示してうまく行ったように感じる。ただし React のところは正直私のレベルが低すぎて私と同等よりちょっと良いくらいにしかなってないと思う。
コンテキスト保持強めっぽいので一貫するタスクは一つのタスクでやる
Gemini は DeepResearch と素の 2.5 Pro をよく使っているのだが、コンテキストを長期間保持できた上に薄まらないし判断を間違えない印象がある。今回面白かった例を挙げておく。
PianoRoll の実装タスクで下記のように指示を出した。
プロンプト
tauri でフロントエンドが React, TypeScript のアプリ上に UI 側のデータ構造である、 Note, Event, Control を追加しました。
このアプリでは VOCALOID や UTAU, Synthesizer V と言った歌声合成に関わるエディタを作ろうとしています。今回はフロントエンド側のデータ構造のうち、特に Note について UI を作っていきます。3つのコンポーネントを作ります。
* PianoKeyboard コンポーネント
* PianoRoll の左に表示されるピアノ鍵盤を表す
* 白鍵・黒鍵によって色分けされており鍵盤ごとにノート名、 C6 などが書かれている
* C6, note=60 のところは基準ドなのでハイライトされたい
* 0-127 の 127 ノートを表示し、それ単体では表示域の調整を持たなくてよいです
* PianoRoll コンポーネント
* ピアノロール本体で 0-127 まで表示されそれ単体では表示域の調整を持たなくてよいです
* 罫線についてはアーキテクチャ上非常に要素が増えてしまうので div 等ではなく canvas で実装してください
* PianoRoll 上にノートが配置されるようにしてください
* Note コンポーネント
* ノートの表示と編集を行うコンポーネントです
* クリックで選択できます
* 選択時に Del キーで削除できます
* 選択時に Enter キーでテキストボックスによる歌詞の修正ができます、再度 Enter で確定し Esc でキャンセルします
* 選択時に Tab で次のノートが選択されます
* ドラッグ&ドロップで位置と音高を変更でき音高はグリッドにひっつく形にします
* 右端をドラッグ&ドロップで長さを調整できます。
作成後テストが必要ならテストも追加してください。
README.md を変更に合わせ更新してください。必要とあらばファイルを分割し、 README.md からリンクをはるかたちにしてもよいです。
最後にビルドやテストなど README.md 上の手順をひと通り試しコマンドが正しく実行できるようにしてください。
この指示からできた UI がこれ。
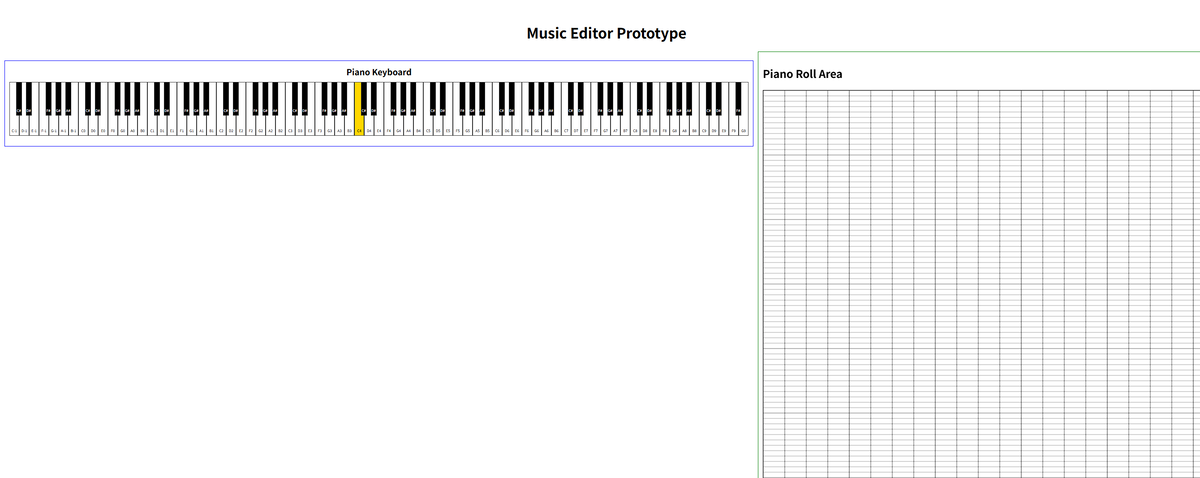
なんやねんと思ったが指示が悪い。普通はボカロエディタなんて使ったことないもんね、と思い直しそれなりにしっかり作られているので再指示を実施。
プロンプト
実装ありがとうございます。指示出しがよくなかったので PianoKeyboard と PianoRoll の関係について、 PianoKeyboard は今回水平方向にキーが広がっていますがこれは誤りで、 PianoRoll の左側に PianoKeyboard を置くことで PianoRoll の各罫線の高さを表すコンポーネントとなる想定です。 そのため PianoKeyboard の向きを変えたうえで PianoKeyboard と PianoRoll はくっつけて表示したいです。 また、追加で依頼ですが PianoRoll は黒鍵の部分に薄い色を追加してほしいです。 指示出しで不明点あれば私に聞いて下さい。
Jules
フィードバックありがとうございます!
1. PianoKeyboard の向きは、垂直方向に変更し、各鍵が PianoRoll のノートの高さ(ピッチ)に対応する形でよろしいでしょうか?(例:上が高音、下が低音)
2. PianoKeyboard と PianoRoll を「くっつけて表示」とは、隙間なく配置し、各鍵の高さとピッチレーンの高さを一致させるという理解でよろしいでしょうか?
3. PianoRoll の黒鍵部分の薄い色は、黒鍵に相当するピッチの行(レーン)に薄い背景色を付けるという理解でよろしいでしょうか?
詳細を教えていただけると幸いです。
1. PianoKeyboard の向きは、垂直方向に変更し、各鍵が PianoRoll のノートの高さ(ピッチ)に対応する形でよろしいでしょうか?(例:上が高音、下が低音)
2. PianoKeyboard と PianoRoll を「くっつけて表示」とは、隙間なく配置し、各鍵の高さとピッチレーンの高さを一致させるという理解でよろしいでしょうか?
3. PianoRoll の黒鍵部分の薄い色は、黒鍵に相当するピッチの行(レーン)に薄い背景色を付けるという理解でよろしいでしょうか?
詳細を教えていただけると幸いです。
再質問あり、急に日本語喋るじゃん助かる。
プロンプト
1. はい、正しいです。 PianoRoll と合わせる都合上鍵盤一つ一つの高さも PianoRoll と合わせたいです。
2. 良いです。ただし PianoKeyboard の幅を調整できるよう、 PianoKeyboard と PianoRoll の間の境界線をドラッグアンドドロップでサイズ変更する可能性はあります。
3. あってます!色については一旦お任せします。
2. 良いです。ただし PianoKeyboard の幅を調整できるよう、 PianoKeyboard と PianoRoll の間の境界線をドラッグアンドドロップでサイズ変更する可能性はあります。
3. あってます!色については一旦お任せします。
再回答して出てきたのがこれ。
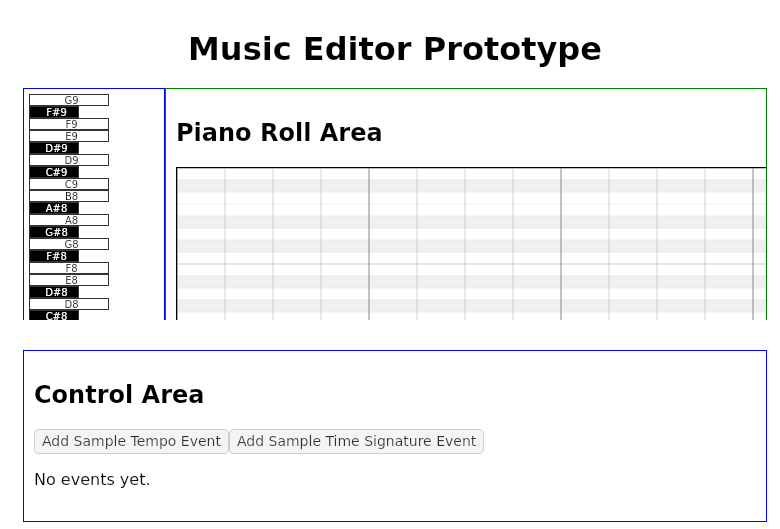
それなりに良さそうなので再指示。
プロンプト
ありがとう。とても良い感じになりました。 7点修正されたいです。
PianoRoll を表示しているエリアの Piano Roll Area のラベルは不要です。
PianoKeyboard を表示しているエリアの Piano Keyboard Area のラベルは不要です
PianoRoll を表示しているコンポーネントにパディングなどの設定があるので0にしてほしいです
PianoKeyboard を表示しているコンポーネントにパディングなどの設定があるので0にしてほしいです
PianoKeyboard の白鍵の高さをしっかり見るために境界線を 1px 追加してください
PianoKeyboard の黒鍵の幅は白鍵と同じで良いです。ビジュアルよりこちらを優先してください
PianoKeyboard と PianoRoll のスクロールを同期させてください
Jules
フィードバックありがとうございます!7点の修正点、承知いたしました。
1点確認させてください。「PianoKeyboard と PianoRoll のスクロールを同期させてください」についてです。 現状、これらのコンポーネントは全域(0-127鍵)を表示しており、単体ではスクロール機能を持っていません。App.tsxのメインコンテンツエリアにスクロールが発生する場合、その親のスクロールを同期させるイメージでしょうか? それとも、各コンポーネントに表示範囲を限定する機能(例:画面に収まらない場合にスクロールバーを出す)を追加し、そのスクロールを同期させるイメージでしょうか?
この点をもう少し詳しく教えていただけますでしょうか。
1点確認させてください。「PianoKeyboard と PianoRoll のスクロールを同期させてください」についてです。 現状、これらのコンポーネントは全域(0-127鍵)を表示しており、単体ではスクロール機能を持っていません。App.tsxのメインコンテンツエリアにスクロールが発生する場合、その親のスクロールを同期させるイメージでしょうか? それとも、各コンポーネントに表示範囲を限定する機能(例:画面に収まらない場合にスクロールバーを出す)を追加し、そのスクロールを同期させるイメージでしょうか?
この点をもう少し詳しく教えていただけますでしょうか。
プロンプト
いまって、 PianoKeyboard も PianoRoll も同じコンポーネントに入ってるんでしたっけ?同じなら親のスクロールを同期させるで良いと思いますが、私はなにか変なこと言っていますか?
Jules
ご説明ありがとうございます!
現状、App.tsx 内の main-content という div が PianoKeyboard と PianoRoll を含んでおり、この main-content が画面の高さを超える場合にスクロールします。
この main-content のスクロールを同期させる、つまり main-content がスクロールされたら、PianoKeyboard と PianoRoll の表示されている部分が常に同じ高さになるように調整する、という理解でよろしいでしょうか?
この理解でよろしければ、新しい計画を立てさせていただきます。
現状、App.tsx 内の main-content という div が PianoKeyboard と PianoRoll を含んでおり、この main-content が画面の高さを超える場合にスクロールします。
この main-content のスクロールを同期させる、つまり main-content がスクロールされたら、PianoKeyboard と PianoRoll の表示されている部分が常に同じ高さになるように調整する、という理解でよろしいでしょうか?
この理解でよろしければ、新しい計画を立てさせていただきます。
プロンプト
良いです!!よろしくお願いいたします!!
これで出てきたのが成果物なので同一タスク内での一貫性がかなり良いように思う。 Gemini のコンテキスト窓が長いのは感じていたけれどちょっとすごいと思った。
とりあえず記事にしておくべきだと思ったのでこんなもん、今日はここまで。
音声を伸縮したりピッチを変えたり編集するツールを試作してみた
概要
A.I. Voice の琴葉姉妹を購入したので、 Text2Speech で作成した音声をあとからちょっと色付けできるツールを作ってみた。ただ、私としてそこまで Text2Speech をやりたかったわけではないので、これが使えるツールになっているのかはわからない。どちらかというと下記の記事の続きものであり技術検証じみた趣味の開発であって、自身のニーズすらないところで作っているので的外れ感はあるかもしれない。
成果物とやれること
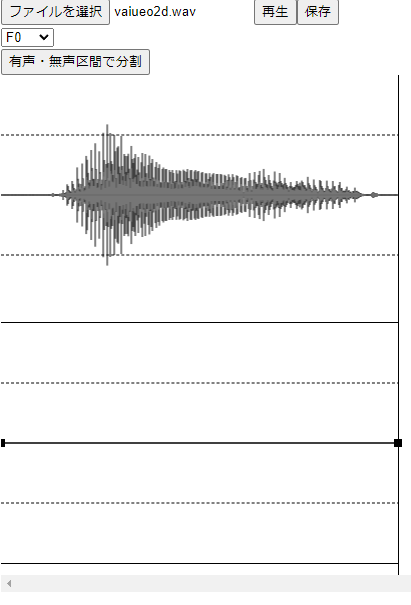
44.1kHz 16bit の音声ファイルを下記のように編集できる
- 波形の上でダブルクリックすることで区間を分ける
- 区間の長さをドラッグアンドドロップで伸縮ができる
- 下の部分の制御点(四角いやつ)をドラッグアンドドロップで音声の高さ(F0: 周波数, GEN: 声質の高い低い)を調整できる
- 下の部分でダブルクリックすることで制御点を追加できる
また、有声・無声区間を分けることで簡単な区間わけができるようになっている。 undo, redo とかでは実装する気力がなくてやれていない。
技術的所感
はじまりは自身の C++ のライブラリを TypeScript から使いたかったので emscripten を使い始めた。たしかに emscripten は C++ のごとき操作性を TypeScript の世界に持ち込んでくれる。が、いささか過保護であり C++ の世界観を持ち込むために wasm の限界を忘れているように思う。というのも wasm は VM とその VM 上で使える関数とメモリ領域を持っているだけなのに、あたかも C++ のように見せたいがため wasm 以外の JavaScript の領域にあまりにはみ出しすぎている。その流儀も C 言語の流儀に近く、 wasm が売れたとしてでは emscripten ごと受け入れられるのか?と言われるとやや懐疑的に見える。結局 wasm の限界をちゃんと見定めないと今はいいけどあとで死にそうだなと思った。あくまで wasm はプリミティブで処理速度の必要な範囲でとても小さく作るべきだなと思った。 一方で react はとても使いやすかった。理解しやすいし作りやすい。ただ、状態管理を行う際にシャローコピーやディープコピーといったプリミティブなところを結局気にしなければいけなかったり、 react 自身の暗黙の副作用を理解する必要があってつらいなあと思った。まあでもこれは過去 Qt を使って SIGNAL/SLOT を使っていたときよりはだいぶ楽になったと思う。 総じて見れば家事・育児を半分引き受けつつ仕事をしながら三ヶ月でこれくらいのものが作れるのであれば、案外余裕はあるんだなという所感を得た。一方で家族と話したり顔を見たりする時間は確実に減るので両立できないもどかしさは残る。トレードオフなので仕方ないか。
